miércoles, 13 de junio de 2007

Se viene el nuevo Eclipse Europa

The Next Total Eclipse
Así como el año pasado salió el Eclipse Callisto, este año sale el Eclipse Europa. Como dice en el sitio web, Europa es la salida en simultáneo de 21 proyectos con el objetivo de eliminar las posibilidades de incompatibilidades entre ellos.

Faltan 16 días...

sábado, 26 de mayo de 2007

HTML a PDF y otras transformaciónes con Open Office como Server

El problema

Hace unos días me vi forzado a buscar una manera de convertir documentos HTML a PDF por un requerimento en el laburo. Los prerrequisitos eran: tiene que ser algo que se pueda hacer desde Java y que no haya que pagar ninguna licencia.

Primera aproximación

Comencé mi búsqueda en Google con cosas como html2pdf java. Más allá de que era complicado encontrar algún resultado copado, la mayoría de las estrategias que aparecían iban por el lado de:
  1. Convertir el HTML a XHTML (por ejemplo con JTidy)
  2. Convertir el XHTML a XSL-FO (Extensible Stylesheet Language Formatting Objects) usando una hoja de estilo XSL y un trasformador XSLT (por ejemplo con Xalan)
  3. Formatear el XSL-FO para finalmente generar un PDF (por ejemplo con FOP)
Esta guía explica muy bien cómo seguir esta estrategia. El asunto es que FOP aún no soporta por completo el estandar de XSL-FO y los PDF generados mediante esta técnica no quedan nada bien.

Cambio de estrategia

Juan me comentó acerca de este post en PC++ que hablaba de la posibilidad de usar a Open Office en modo servidor y enviarle mensajes mediante un socket. En esos mensajes se le podían decir cosas tan geniales como "abrí este archivo y exportalo a PDF". El post hablaba de usar un script en python, pero tenía que haber una manera de ejecutar eso desde Java (sin llegar a JPython).

Efectivamente, en la página de la API de Open Office encontré que está disponible para Java, C++ y Python.

La Solución

Luego de lidiar un rato con la API de Open Office dije "tiene que haber algo más fácil". Fue así como llegué a JODConverter (Java Open Document Converter).

JODConverter es una bibiloteca que encapsula las dificultades de conexión a Open Office que impone el uso de la API oficial y hace que su uso sea tan simple como esto:
  // it will guess the format based on the file extensions
File inputFile = new File("document.doc");
File outputFile = new File("document.pdf");

// connect to an OpenOffice.org instance running on port 8100
OpenOfficeConnection connection = new SocketOpenOfficeConnection(8100);
connection.connect();

// convert - input and output formats are guessed from file extensions
DocumentConverter converter = new OpenOfficeDocumentConverter(connection);
converter.convert(inputFile, outputFile);

// close the connection
connection.disconnect();
JODConverter tiene pocas dependencias, pero está en el mvnrepository, así que si usás maven vas a salir andando en 5 minutos.

Configurando Open Office

Y sí, algo hay que hacer para que Open Office responda mis pedidos de conversión de archivos, pero también es muy simple. Hay que iniciarlo en modo servidor y decirle que escuche en algún puerto (para estos ejemplos, uso el puerto 8100, pero cualquiera que esté libre debería servir). Suponiendo que el ejecutable es soffice:
soffice -headless -accept="socket,port=8100;urp;"
Issue conocido

Hay un problema reportado en Open Office que impide que el servidor de Open Office pueda correr en una computadora diferente a la que lo invoca.

En el ejemplo de más arriba usamos a la clase SocketOpenOfficeConnection. Esta clase lo que hace es usar el socket con Open Office para darle las instrucciones, pero el archivo se pasa por referencia y Open Office debe tener permiso para abrirlo del Filesystem (y permiso de escritura para guardar el resultado). Existe otra clase llamada StreamOpenOfficeDocumentConverter que envía y recibe el contenido de los archivos por socket. Esta clase es la que no funciona bien por el bug de Open Office.


Espero que a alguien le sirva toda esta data :D

miércoles, 2 de mayo de 2007

Linux Ubuntu vendrá preinstalado en algunas Dell

Tanto en el sitio de Ubuntu como en el de Dell están anunciando oficialmente que algunas computadoras Dell podrán venir con Ubuntu 7.04 Feisty preinstalado.

Es una gran noticia y estaría bueno que otras marcas de computadoras los imiten. A mi me encanta Ubuntu, así que el hecho de que esa sea la distro de Linux elegida me pone también muy contento, pero también podrían ser otras las distros a elegir.

Claro que hay distros que nunca podrían venir preinstaladas porque se perdería su filosofía. Tengo un amigo al que le encanta Gentoo, pero claro, le gusta instalarlo él mismo :D

jueves, 26 de abril de 2007

apt-get con poderes de super vaca!!


Hoy me sorprendí con algo que se ve que existe hace mucho pero que yo no conocía.

El apt-get tiene poderes de super vaca!!! (ver la imagen que se obtiene luego de ejecutar apt-get --help)

Más divertido aún es lo que aparece con apt-get moo :D

domingo, 1 de abril de 2007

Ya salió la nueva joda de GMail por el primero de abril

Hoy es primero de abril y como es tradicional, ya Google nos trajo un chiste (y si no lo vieron, yo ya se los arruiné, ja)

La idea esta vez es que te envían los mails impresos por correo.

lunes, 15 de enero de 2007

Se me llenó el GMail

Hoy se me llenó la casilla de Gmail. La estaba dejando llenar para ver qué pasaba. Pues bien, llega un momento en el que no te deja enviar mail porque dice que no tiene lugar (en la imagen se ve el mensaje).

También se puede ver que la cuenta no está en realidad llena, sino que sobran tres megabytes (usando 2802 de 2805 MB). Vaya uno a saber si es un bug o una feature :P

viernes, 1 de diciembre de 2006

Microstrategy y las bases de datos Open Source

Durante noviembre tuve que hacer un trabajo práctico para la facultad utilizando Microstrategy.

El tema del trabajo era business intelligence, basándose en datos de un típico Video Club. Estaba todo planeado para usar una base de datos IMB DB2, hacer el ETL también con un producto de IBM que no recuerdo el nombre y finalmente acceder a todo eso desde Microstrategy.

Entre los integrantes del grupo para hacer el TP estaba Juan F. Codagnone y como él la tiene muy clara con PostgreSQL quisimos probar con eso. Al fin y al cabo, DB2 es una mierda total, super lenta y con una interfaz horrible y llena de bugs (yo me pregunto a quién se le ocurre pagar por eso hoy en día). Encontramos que Microstrategy había incorporado soporte para bases de datos Open Source y le dimos para adelante.

Todo el trabajo sobre PostgreSQL resultó genial. Tuvimos un warehouse con ETLs hechos a mano (mezcla de scrips de bash, awk y un poco de SQL, en su mayoría hechos por Juan) en poco tiempo y sin problemas.

El problema fue con Microstrategy. Usamos Microstrategy versión 8.0.2 y PostgreSQL versión 8.1.5-1, todo en Windows como decía Microstrategy que soportaba.

Microstrategy tiene unas consultas SQL que utiliza para tomar la metadata de las tablas de la base (léase nombre de las tablas y nombres y tipos de las columnas). De entrada el SQL para levantar los nombres de las tablas tenía errores de sintaxis. Este es el SQL original:

SELECT DISTINCT
TABLE_CATALOG as NAME_SPACE,
TABLE_NAME as TAB_NAME,
COLUMN_NAME as COL_NAME,
DATA_TYPE as DATA_TYPE,
CHARACTER_MAXIMUM_LENGTH as DATA_LEN,
NUMERIC_PRECISION as DATA_PREC,
NUMERIC_SCALE as DATA_SCALE
FROM INFORMATION_SCHEMA.COLUMNS
WHERE TABLE_NAME IN ('#TABLE_LIST#') Order by 1,2,3

El #TABLE_LIST# es reemplazado por el nombre entre comillas simples de la tabla que se busca, por ejemplo 'lu_peliculas' (el prefijo lu_ es una convención para referenciar a las tablas de lookup). Cuando reemplazaba en el SQL original quedaba ...TABLE_NAME IN (''lu_peliculas'')... y daba error por las comillas simples repetidas.

Solucionado este inconveniente (por suerte el SQL ese es personalizable), había otro. En la consulta mencionada dice TABLE_CATALOG as NAME_SPACE y en la consulta que utiliza para buscar las tablas dice TABLE_SCHEMA as NAME_SPACE. Como TABLE_SCHEMA no es lo mismo que TABLE_CATALOG (y Microstrategy internamiente los asociaba como lo mismo), luego tenía tablas que para él no tenían columnas.

Al corregir ese problema surgieron más. No nos detectaba bien los tipos de datos de las columnas. Sólo detectaba bien los tipos date, con lo cual luego nos llenaba de errores de Unknown type.

Ya estábamos por mandar todo al carajo y rendirnos a usar la mierda de DB2 cuando se nos ocurrió ver qué pasaba si creabamos nuestro catálogo de tablas en MySQL y hacíamos que microstrategy tomara la metadata de allí. Esto fue finalmente la solución. No podíamos pasar todo a MySQL porque en nuestros SQL estábamos usando algunas cosas que PostgreSQL soporta y MySQL, no. Pero, para reconocer a las tablas y sus columnas, a Microstrategy le alcanzaba con que estuvieran creadas las tablas. Una vez reconocido todo, podíamos cambiar la conexión de la base y que hiciera los SELECTs a PostgreSQL (los SELECTs son la especialidad de Microstrategy).

Como conclusión, me parece una vergüenza que Microstrategy anuncie que soporta bases Open Source cuando al intentar usar una de ellas pareciera que ni siquiera la probaron (como dije antes, el SQL generado tenía errores de sintaxis). Por suerte pudimos solucionarlo, pero fue algo que nos quitó mucho tiempo y que nos hizo odiar un poco a Microstrategy. Lo que sí hay que reconocer es que una vez que Microstrategy está bien configurado, es una herramienta potentísima para extraer datos y generar reportes de todo tipo.

Cabe aclarar que la versión de Microstrategy que utilizamos corresponde a una demo que nos dio la gente de Microstrategy en DVD. Es probable que haya algún fix posterior a esa versión que solucione estos inconvenientes, pero no lo se. De todas formas, que el script de SQL ni siquiera compile es impresentable.

martes, 17 de octubre de 2006

Mash up de Flof

Ya les hablé de flof en algún otro post. Hoy les quiero contar que armé mi primer mash up sobre flof (así le llaman ellos).

Pensé que era el primero que se hacía, pero me enteré que es el segundo (el primero es en este blog).

Hacer mash up con flof es muy simple. Sólo hace falta poner un iframe como este:

y se obtiene algo así:


Lo que yo hice lo pueden ver en epere4.com.ar. Ahí armé una página donde puedo poner mis mapas favoritos. Por default me carga el primer mapa de mi lista y luego, al hacer click en los links se van cargando los otros. Una vez que un mapa quedó cargado, ir a él es rápido porque queda cacheado en el browser.

A lo mejor, si la idea interesa, puedo llegar a armar alguna web donde cada uno pueda tener sus propios mapas favoritos. Dejame tus comentarios.

sábado, 16 de septiembre de 2006

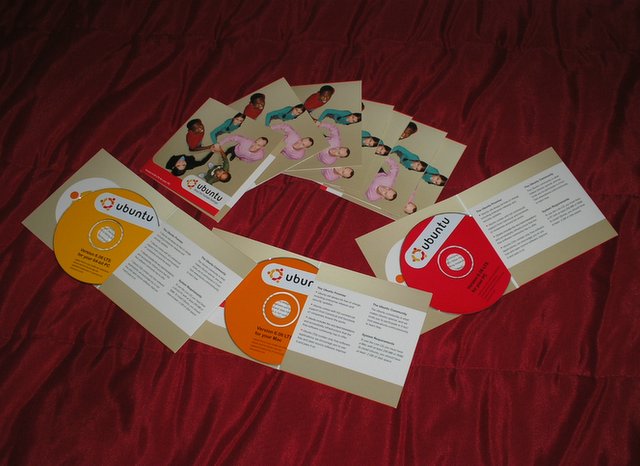
¡Llegaron mis CDs de Ubuntu!

Luego de 1 mes y 20 días de espera, llegaron finalmente los CDs de Ubuntu que encargué en su momento. Pedí el pack de 10 CDs que viene con uno para Mac, uno para AMD 64 bit y el resto para x86, tal como se pueden ver en la foto.

Ya casi había perdido las esperanzas, porque dos amigos míos habían pedido los suyos después que yo y los habían recibido antes. Por suerte no se perdieron en el correo y acá están :)

Vengo usando Ubuntu desde el 26 de Julio y la verdad es que estoy super conforme. Es realmente un Linux fácil.

Planeo quedarme con uno solo de los CDs de x86 y al resto regalarlos, así que si me conocés personalmente y querés probar Ubuntu, me podés pedir uno. Posted by Picasa

martes, 12 de septiembre de 2006

Performance de manipulación del DOM con Javascript en Internet Explorer

Hoy pasé la última parte de la tarde y comienzo de la noche luchando con un problema de performance al manipular el DOM de html con Javascript en Internet Explorer.

Resulta que en el trabajo tenemos una tabla que hubo que partir en dos para agregarle scroll horizontal a partir de cierta columna. Para hacer esto, lo que se hizo fue partir dinámicamente la tabla en dos (o sea, se construyó una tabla con las columnas 1 a j y otra con las columnas j+1 a n, siendo n la cantidad de columnas y j el número de columna de corte).

El problema surgió cuando la tabla de la izquierda tenía filas con distinta altura que la tabla de la derecha. Se hizo un arreglo que consistía en recorrer las filas de las dos tablas comparando las altura (row.height) y corrigiendo cuando eran diferentes. Ahí comenzamos a tener problemas de performance, porque la tabla puede tener hasta 600 filas. En el Firefox no teníamos problemas porque se las ingenia para hacer esto bien, pero en Internet Explorer tardaba una eternidad.

Da la impresión de que Internet Explorer quiere redibujar enseguida la tabla apenas le cambiamos la altura a una fila (imagínense lo que tarda redibujando la tabla de 600 filas unas 600 veces).

Me partí el bocho buscando maneras de mejorarle la performance a esto. Gasté un montón de tiempo intentando implenetar la solución que proponen en esta página (a pesar de que es muy sucia), pero no sólo no mejoró los tiempos, sino que los empeoró levemente.

Ya me estaba por rendir a la frustración cuando se me ocurrió probar qué pasaba si ocultaba todo antes de hacer los ajustes y lo volvía a mostrar después (seteando el style.display = 'none' y luego volviéndolo a setear en style.display = 'inline'). Mi razonamiento fue "a lo mejor si está oculto no intenta redibujar nada" ¡y tuve suerte!

Este simple y miserable cambio hizo que el ajuste de cada fila pasara de tomar unos 70 milisegundos a tomar sólo 2!! Al parecer, con esto se logra que el browser difiera el redibujado de los componentes hasta el momento en que se muestran realmente.

Me quedé muy contento y por eso lo comparto. A lo mejor es algo super conocido, pero no logré que Google me encontrara ningún tip relacionado con esto.


¡Espero que a alguien más le sirva!

miércoles, 26 de julio de 2006

Linux Ubuntu

La verdad es que no hice mucho progreso con el tema anterior sobre el GWT (no se me presentó un caso práctico para usarlo), pero hoy me comentaron de la existencia de la distribución de Linux Ubuntu.

Se trata de una distribución basada en Debian, y viene en dos versiones: servidor y escritorio. Se puede descargar desde el sitio web o encargar el CD de manera gratuita (esto me sorprendió y pedí el CD hoy mismo, vamos a ver si llega).

Por lo poco que probé hasta ahora de la distro para escritorio (desktop) puedo decir que me sorprendió que me detectara y configurara correctamente hasta mi placa de Wi-Fi. Tiene muchas cosas configurables mediante la GUI (todavía no tuve necesidad de abrir la consola y, viniendo de la distribución Gentoo, esto es muy nuevo para mi :P)

Creo que parte de la filosofía de esta distro es "Linux fácil" o "Linux para todos", así que si estás buscando tener Linux sin complicarte la vida y con una base sólida (el nexo con la gente de Debian es muy estrecho, incluso comparten desarrolladores), entonces esta puede ser la que estás buscando. Remarco el puede ser porque hoy es mi primer día usándola, así que todavía no la puedo recomendar =)

Más info en la Wikipedia en Español.

sábado, 17 de junio de 2006

GWT - Google Web Toolkit

Ya muchos habrán oido hablar del GWT. Se trata de un framework de desarrollo de front-ends web en el cual uno escribe y prueba el código totalmente en Java y una vez que está contento lo traduce a Javascript.

Yo en un comienzo no le di mucha bolilla porque no me había dado cuenta de que la aplicación corría totalmente en la Java Virtual Machine durante el desarrollo. La gente de Google desarrolló un ambiente de prueba que simula ser un browser, pero funcionando en Java, con lo cual uno puede depurar el código (que luego será Javascript) en, por ejemplo, el Eclipse. Tiene algunas limitaciones en cuanto a los métodos de Java que se pueden utilizar de los paquetes java.lang y java.util (que fueron migrados a Javascript), pero es muy bueno.

Hace un par de días estuve haciendo unas pequeñas pruebas y parece muy prometedor. Ya les contaré más...

jueves, 15 de junio de 2006

LinkedIn

Hace poco descubrí que existía LinkedIn.

Se trata de una red de contactos laborales, donde vos podés pedir y ofrecer trabajo a tu red de contactos.

Tu red de contactos son tus contactos directos y los contactos de ellos, con lo cual se hace mucha gente.

En el perfil de cada persona se puede poner el lugar actual de trabajo y los lugares anteriores, así como también la universidad y escuela donde uno estudió. Esto permite buscar contactos en gente que haya trabajado (o trabaje) en esos lugares, o que haya estudiado la misma institución, etc.

También se puede publicar el perfil propio con una url más o menos bonita (este es el mío, por ejemplo: http://www.linkedin.com/in/epere4).

sábado, 10 de junio de 2006

flof - el mundo en etiquetas

Se lanzó hoy este sitio que permite etiquetar puntos geográficos y catalogarlos arbitrariamente. Lo hicieron unos amigos míos y lo recomiendo porque está muy bueno.

La idea es que si conocés un bar copado, sabés la ubicación de un cajero automático, un estacionamiento o lo que se te ocurra, lo marques en el mapa de flof (usa Google Map) y le pongas etiquetas. La onda es muy similar a la manera en que en del.icio.us se etiquetan urls.

Los puntos que vos marcas son públicos. Esto permite que puedas ver lo que otros marcaron y así saber de nuevos bares, estacionamientos en una zona a la que vas por primera vez, etc.

¿La dirección? flof.com.ar

miércoles, 1 de septiembre de 2004